技术分享
LLM 在嵌入式产品开发中的应用
在一颗给监控用的芯片上:踩坑、填坑,和被我们「管住」的大模型
案例:AI 拍学机 · Anyka AK3918AV200 RISC-V64 · v1.1.23
amass · 2026.06.17
AGENDA / 目录
内容提要
给监控做的 SoC,偏要做带屏产品:一笔成本账
显示卡死 / 触摸空转 / 拍照崩溃 / 圆角画错:真实 commit
成百上千张照片,如何在 64MB 里滚得动
它帮了什么、哪些我没交给它,以及一个判断
- 前三块是具体的活;方法,放到第四块再揭晓:因为方法是为「解决问题」而存在的
01 · 一颗「用偏了」的芯片
资源极限下的「逆势」机会
双核 800MHz
主控 CPU
FLASH
固件 + 图片/字体等资源
RAM
系统+UI+业务+相机MPP
Anyka SoC
KM02D · 拍学机
- 内存 / 存储持续涨价,高配方案成本承压:这正是拍学机仍能做的原因
- 靠「极限资源也能跑」维持产品的可做性与价格竞争力
- 结论:软件侧「把每一 KB / 每一 MHz 省下来」成为核心竞争力
- 也正因资源紧张,软件用 C 开发,对 LLM 的「约束」变得格外关键
01 · 一颗「用偏了」的芯片
第一个吃螃蟹的人
- 优势:价格便宜,适配涨价行情
- 短板:面向监控,带屏 / GUI 生态近乎空白
- 短板:SDK 不完善 / 文档少 / 范例少
- 短板:带屏 LVGL UI 先例稀缺,需自行趟水
- 优势:做带屏设备是主场,生态成熟
- 优势:大量 UI / 多媒体参考代码
- 短板:成本更高
- 资源不再是核心约束
- 越是「没有现成答案」的趟水场景,LLM 迁移成熟经验的价值越大
02 · 四个监控用不到的坑
摄像机芯片的「盲区模块」
- ISP / Sensor 图像调校
- 视频编码 · VI 采集
- 网络推流 / 录像
- 厂商交付调好的二进制 .ko(如 ak_vi.ko)
- 本地 LCD 显示(FB / LCDC)
- 电容触摸(evdev / tslib)
- GUI 物理内存(CMA / DMA 分区)
- 提示音播放 · 本地 OTA 升级
- 监控摄像头「不看屏、不触摸、不跑 GUI」:这些路径 SDK 从未被充分验证
- 于是它们成了「隐藏 bug 集中区」:编译能过、单点能跑,一上量 / 长跑就暴雷
02 · 四个监控用不到的坑 · 真实 commit
四个真实的「隐藏 bug」

现象
UI 偶发卡死、不再刷新
根因
wait_fb_available 死循环轮询 LCDC,永不超时
commit
fix(fb) 5476ca4b · FB看门狗 3003bc2f
现象
无人操作时也跑满一核,系统静态 CPU≈50%
根因
ts 非阻塞打开、立即返回,又无延时 → 线程 while(1) 空转
commit
fix(touch) e05a553d · 修复后静态≈10%
现象
高清拍照 / 连拍崩溃
根因
相机与 GUI 争抢 CMA/DMA 连续内存
commit
dma 48M→56M · 61435ae7
现象
矩形半出屏,真机交界处冒出圆角;模拟器正常
根因
安凯硬件加速绘制驱动把坐标钳到 0,圆心被搬进屏内
commit
lv_draw_fill_anyka 锚定真坐标 · 边界检查
- 共同点:都落在「摄像机用不到、拍学机偏要用」的路径上,连案例 D(安凯交付的硬件加速绘制驱动)都不例外
02 · 四个监控用不到的坑 · 排障
如何定位 · 如何解决
// 把「无限轮询」改成「有上限 + 卡住打点」
static void wait_fb_available(fb_info_t *fb) {
  int lcdc_status = AK_SUCCESS;        // 顺手初始化
  unsigned long lcdc_is_busy = AK_FALSE;
  int retry = 0;
  while (1) {
    /* ... 查询 LCDC 是否空闲 ... */
    if (!lcdc_is_busy) break;
    AK_BASE_SleepMs(2);
    if (++retry == 1000)         // 1000 x 2ms = 2s
      printf("[wait_fb] STUCK busy=%lu st=%d\n",
             lcdc_is_busy, lcdc_status);
  }
}
- 看门狗兜底:先让卡死能被抓住 / 复位(FB flush watchdog)
- 无限等待 → 超时 + STUCK 打点:while(1) 加上限并打印现场
- 忙等 → 阻塞等待:非阻塞 ts_read 前加 poll(timeout),让出 CPU
- 自建可视化监控:DMA / LVGL 内存监视器,让争抢看得见
- 定位别先入为主:先别怀疑自己的应用代码,也查驱动 / 底层,案例 A 在 FB 驱动、D 在安凯绘制驱动
- 把这些排障招法沉淀成规范喂给 LLM:让它按嵌入式方式排查,而非桌面思维
03 · 一个 LVGL 没有的列表
超大照片列表的性能悬崖
- 朴素实现:每张照片创建一个 LVGL obj,N 张照片 = N 个对象
- 对象树、样式、图片缓存随 N 线性增长:
- CPU 飙升(布局 / 重绘 / 缓存换入换出)
- 64MB RAM 扛不住成百上千个 obj + 解码缓冲
- 而桌面 / 移动端对这类需求早已成熟:
- Android RecyclerView、iOS UITableView、Web 虚拟滚动
- LVGL 9 无内置虚拟列表(lv_list 每项建一个 obj、不复用)
- 策略:让 LLM 把「虚拟列表 / 对象复用」迁移到 LVGL 9 上实现
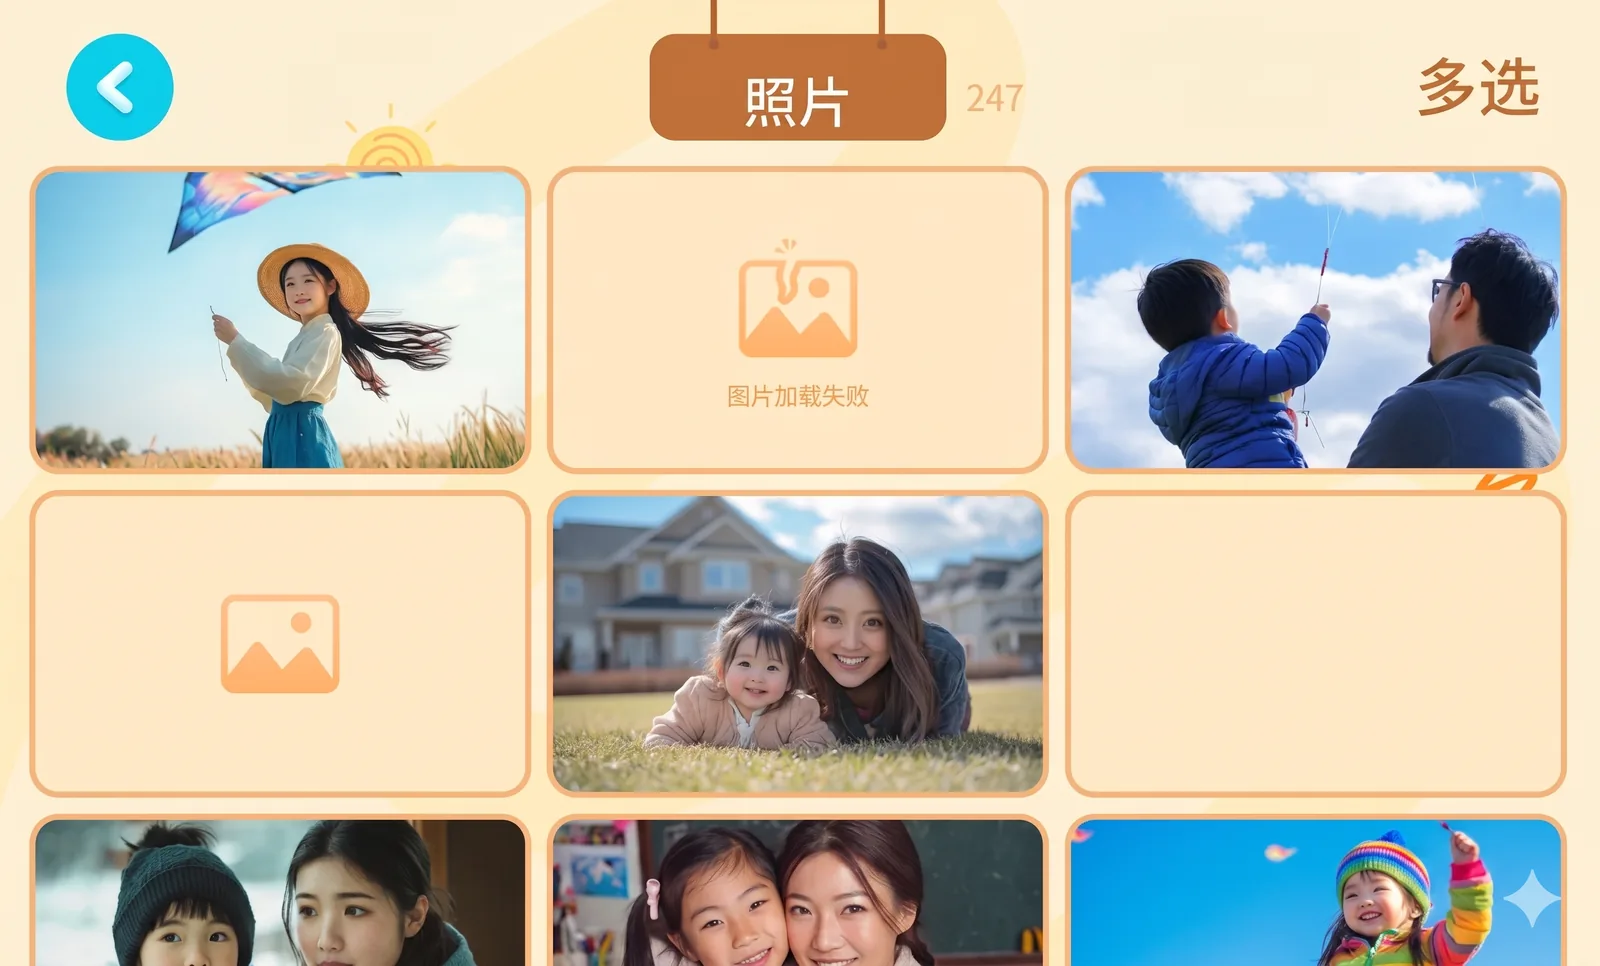
↑ 相册照片列表
03 · 列表 · 真实代码 lv_albums_page.c
实现剖析 ① · View 端对象池窗口化
#define LV_ALBUMS_PAGE_ITEM_CACHE_SIZE 18  // 固定对象池

// 只创建 18 个缩略图对象,循环复用
self->cache_items = lv_malloc_zeroed(
    CACHE_SIZE * sizeof(lv_obj_t *));
for (int i = 0; i < CACHE_SIZE; i++)
    self->cache_items[i] =
        lv_thumbnail_create(self->list_view);

// 滚动时:可见行 → 可见索引 → 预取范围
first_vis_row = scroll_y / row_h;
last_vis_row  = (scroll_y + list_h) / row_h;
prefetch_budget = CACHE_SIZE - visible_count;
albums_model_ensure_data_range(model, from, to);
- 只创建 18 个对象,覆盖「可见行 + 预取」
- scroll_placeholder 占位对象撑开滚动高度,滚动条才正确
- list_view 移除 flex、改手动定位 (col×w, row×h)
- 滚动事件 → 重算可见索引 → 复用对象,绝不新建
03 · 列表 · 真实代码 update_visible_items()
实现剖析 ② · 4 趟 slot 复用算法
// ① 索引+路径 精确匹配(最常见的滚动场景)
// ② 仅路径匹配(删除后索引偏移、但路径不变)
//    → set_index(slot, new_idx) 复用,免重读文件
// ③ 释放未认领 slot,收集 free_list
for (i = 0; i < CACHE_SIZE; i++)
    if (!claimed[i]) {
        lv_thumbnail_clear(cache_items[i]);
        free_list[free_count++] = i;  // 预分配,零malloc
    }
// ④ 为未匹配的 index 分配空闲 slot 并加载图片
slot = free_list[free_idx++];
lv_thumbnail_set_path(cache_items[slot], path);
- 第 1 趟:index + 路径精确匹配
- 第 2 趟:仅路径匹配 → 删除后索引偏移仍复用
- 第 3 趟:回收未用 slot 进 free_list
- 第 4 趟:分配空闲 slot 加载缺失图片
- free_list 预分配 → 滚动全程零 malloc/free
03 · 列表 · 真实代码 albums_model.c
实现剖析 ③ · Model 端按需分页 + 防抖
void albums_model_ensure_data_range(self, from, to){
  // 1) 扫描可见范围,找出缺失的数据段
  for (idx = from; idx <= to; idx++)
    if (items[idx] == NULL) /* 记录 missing_from/to */;

  // 2) 不足最小批量则扩展,优先向后预取
  if (cnt < ALBUMS_MODEL_MINIMUM_REQUEST_SIZE) {...}

  // 3) 去重:与上次请求相同则跳过(防滚动抖动)
  if (missing_from != last_request_from ||
      missing_to   != last_request_to) {
    albums_model_request_data(self, from, cnt);
    last_request_from = missing_from; ...
  }
}
- 检测可见范围缺失 → 自动请求
- 扩展到最小批量 MINIMUM_REQUEST_SIZE
- last_request_from/to 去重,避免抖动重复拉取
- UDS 消息异步取数,UI 不阻塞
- eager_load 可选:小数据集一次拉全
03 · 一个 LVGL 没有的列表 · 效果
收益 · 从 O(N) 到 O(窗口)
朴素实现
虚拟列表
- 对象数从「随照片数线性增长」降为「恒定 18 个」
- 内存 / CPU 与照片总数解耦,列表滚动保持流畅
- 删除后按路径匹配复用 slot,避免无谓的文件 I/O 与重新解码
- LLM 把成熟桌面经验搬到 LVGL 9 上(跑在极限 MCU),开发周期显著缩短
04 · 大模型扮演了什么
为什么嵌入式里「约束 LLM」尤其重要
- 嵌入式现实:C 语言、无 GC、堆 / 栈受限、对实时性与内存峰值敏感
- LLM 的「默认偏好」常与嵌入式约束冲突:
- 滥用动态分配 malloc/free,忽视内存峰值与碎片
- 层层抽象、引入重型第三方库,FLASH / RAM 放不下
- 「桌面思维」实现,在 64MB RAM 上直接 OOM / 卡死
- 在 16MB FLASH / 64MB RAM 上,一次「想当然」就可能压垮设备
- 结论:约束(规范)> 放任生成,先立规矩,再让 LLM 在框内加速
04 · 大模型扮演了什么
应用 SDD(Spec-Driven Development)
- 需求
Spec - 设计
Design - 拆解
Tasks - 实现
Implement - 验证
Verify
- 先把「做什么 / 约束 / 接口 / 验收」写成规范,再让 LLM 在规范内实现
- 规范固化关键决策:产出不依赖具体哪个 LLM,都受同一套结构约束
- 人审「规范」而非逐行审代码:规范即评审基线,也是回归测试的依据
- 需求变更时改规范,而不是让 LLM 漫无目的地重写
- 业界印证:Kiro 的 spec、Claude Code / Windsurf 等的 Plan 模式,本质同一思路,先把意图写成可审阅的产物,再约束模型实现
04 · 大模型扮演了什么
回看:虚拟列表,就是 SDD 走了一遍
- 固定「可见窗口」对象池
- MVC:View / Model 分离
- 数据按需分页加载
- 滚动时复用而非重建
- View 持 18 个缩略图对象池
- (LV_ALBUMS_PAGE_ITEM_CACHE_SIZE)
- Model 持链表 + 索引数组
- 按范围 ensure_data_range
- 占位对象撑开滚动区
- 手动定位行列坐标
- 4 趟 slot 复用算法
- 预取预算 prefetch_budget
- PC 模拟器滚动 / 删除回归
- 对象数恒定 = 18
- 滚动中零 malloc/free
- 删除后路径匹配复用
- 关键决策写进 Spec:不依赖具体哪个 LLM,重现的是同一套结构约束,这正是 SDD 的价值
04 · 大模型扮演了什么
实践:抽象 HAL,把硬件无关模块搬到 PC
接口(hal_audio_api.h)与平台实现(hal/<平台>/)分离 · 不透明句柄 void *hal_audio → 上层对「真机 / PC」无感知
改代码 → 交叉编译 → 烧录 → 上机验证(分钟级)
改代码 → LVGL SDL 模拟器秒级运行 + 可视化调试
- 模块与硬件解耦后,Model 层、算法、UI 逻辑直接在 PC(LVGL SDL 模拟器)跑
- PC 上配合 LLM 快速迭代 + 断点 / 可视化调试,再交叉编译回设备
- 「编译-烧录-上机」的分钟级慢循环 → 「PC 秒级迭代」快循环
- 设备上只留硬件相关 + 集成验证;相册 Model(albums_model.c)即纯逻辑零依赖,天然可 PC 化
05 · 边界与机遇
边界与机遇:约束,才让 LLM 真正可用
- 需求不确定 + 大规模 AI 生成 → 易演变「AI 解决 AI」
- 屎山越堆越高,可读性 / 可维护性下降
- token 成本随重构规模不断上涨
- 人定架构 / 接口契约 / 取舍;LLM 只「填空」不「定调」
- LLM ≠ 传统算法:同样输入不保证同样输出
- 单靠 LLM 达不到「几个 9」高可用(99% ~ 99.999%)
- 好用的大模型应用,都在「从工程上约束 LLM」
- 校验 / 重试 / 兜底 / 人审 / 护栏 → 收敛到可用
LLM 不取代工程,反而让「工程约束」空前重要:对工程开发者,既是机遇,也是挑战